3. 従来型の統計的ダウンスケーリングとMLDSの違い
どちらも過去のデータから気象の特徴を学習する方法ですが、推定の手掛かりとモデルの構築方法に違いがあります。
従来型:説明変数と目的変数の関係を学習
例えば、ある地点の降水量を推定するために、気温・湿度・風向風速・気圧・上昇流・地形など、降水に関係すると考えられる要素を説明変数として選びます。
過去の気象条件と観測された降水量との関係を統計モデルや機械学習モデルで学習し、「どのような条件のときに、どのくらい雨が降るのか」を推定します。
学習の中心:
MLDS:気象場のパターンと地点ごとの特性を学習
超解像の考え方を取り入れ、低解像度の気象場に現れる空間パターンと、それに対応する高解像度の気象特性を学習します。
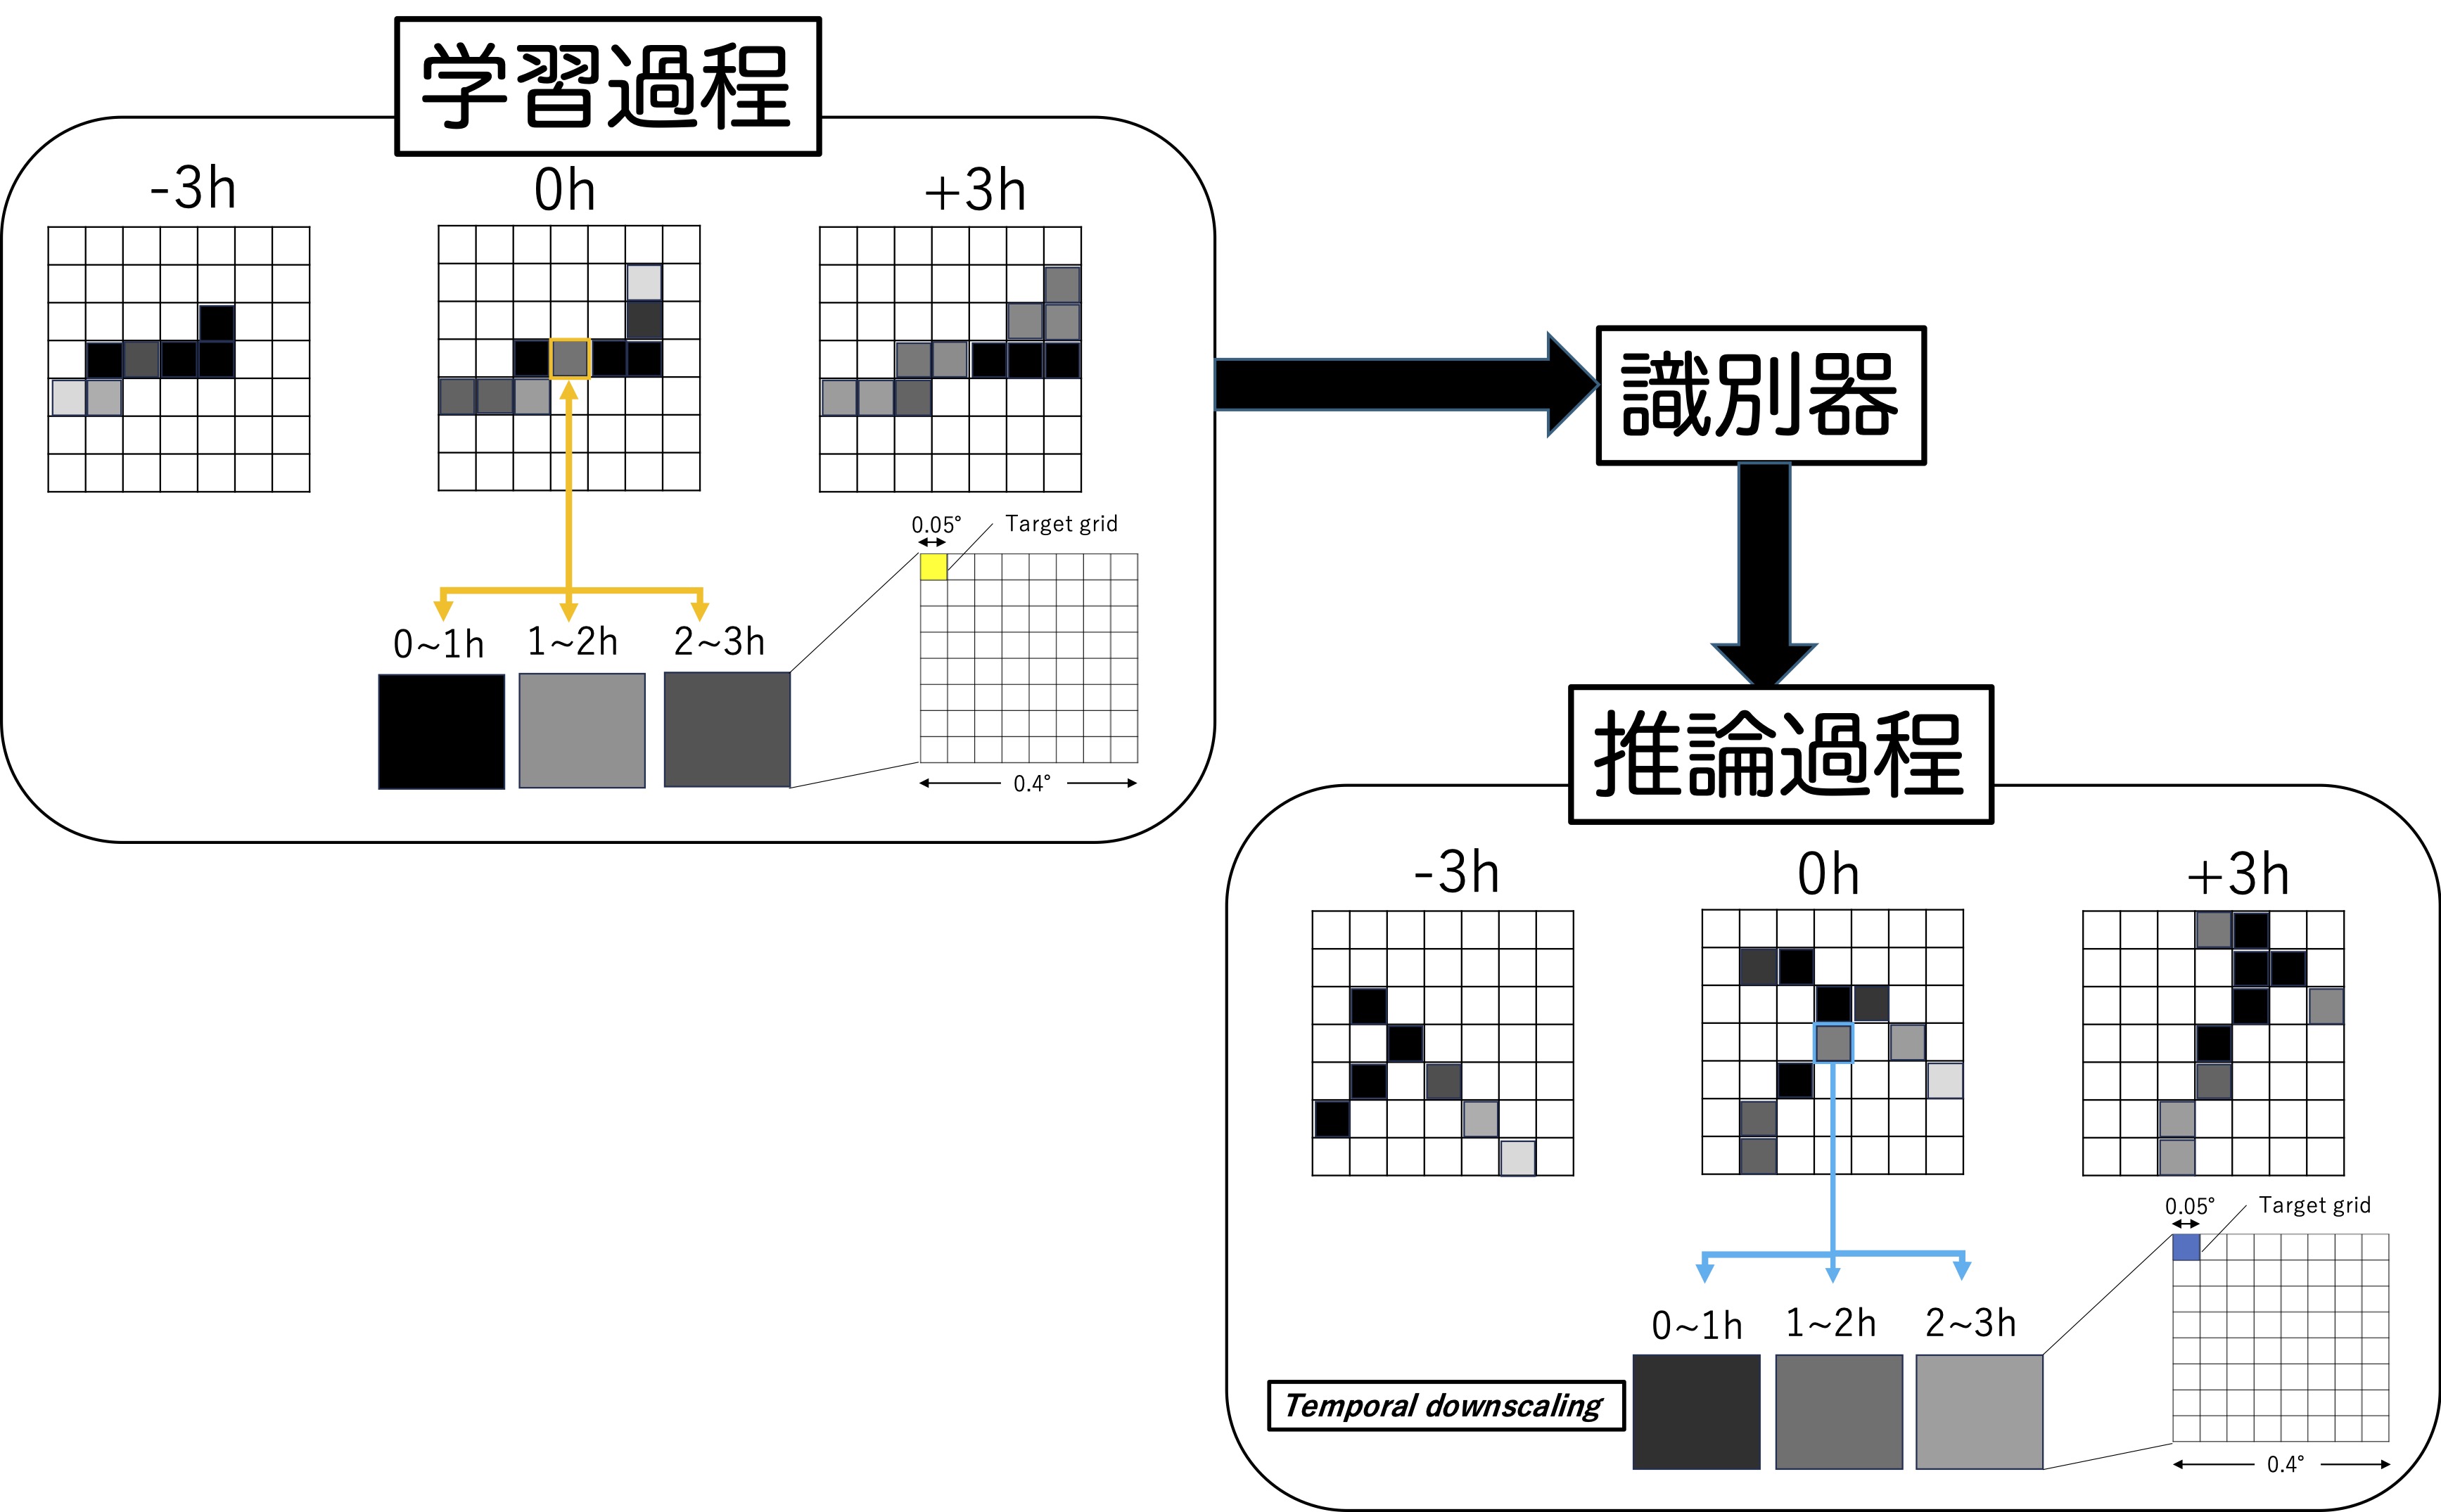
特徴的なのは、地点ごとに識別器を構築し、周辺の格子を含む気象場のパターンから、その地点における気象の現れ方を推定することです。
学習の中心:
超解像の考え方を気象データに応用する
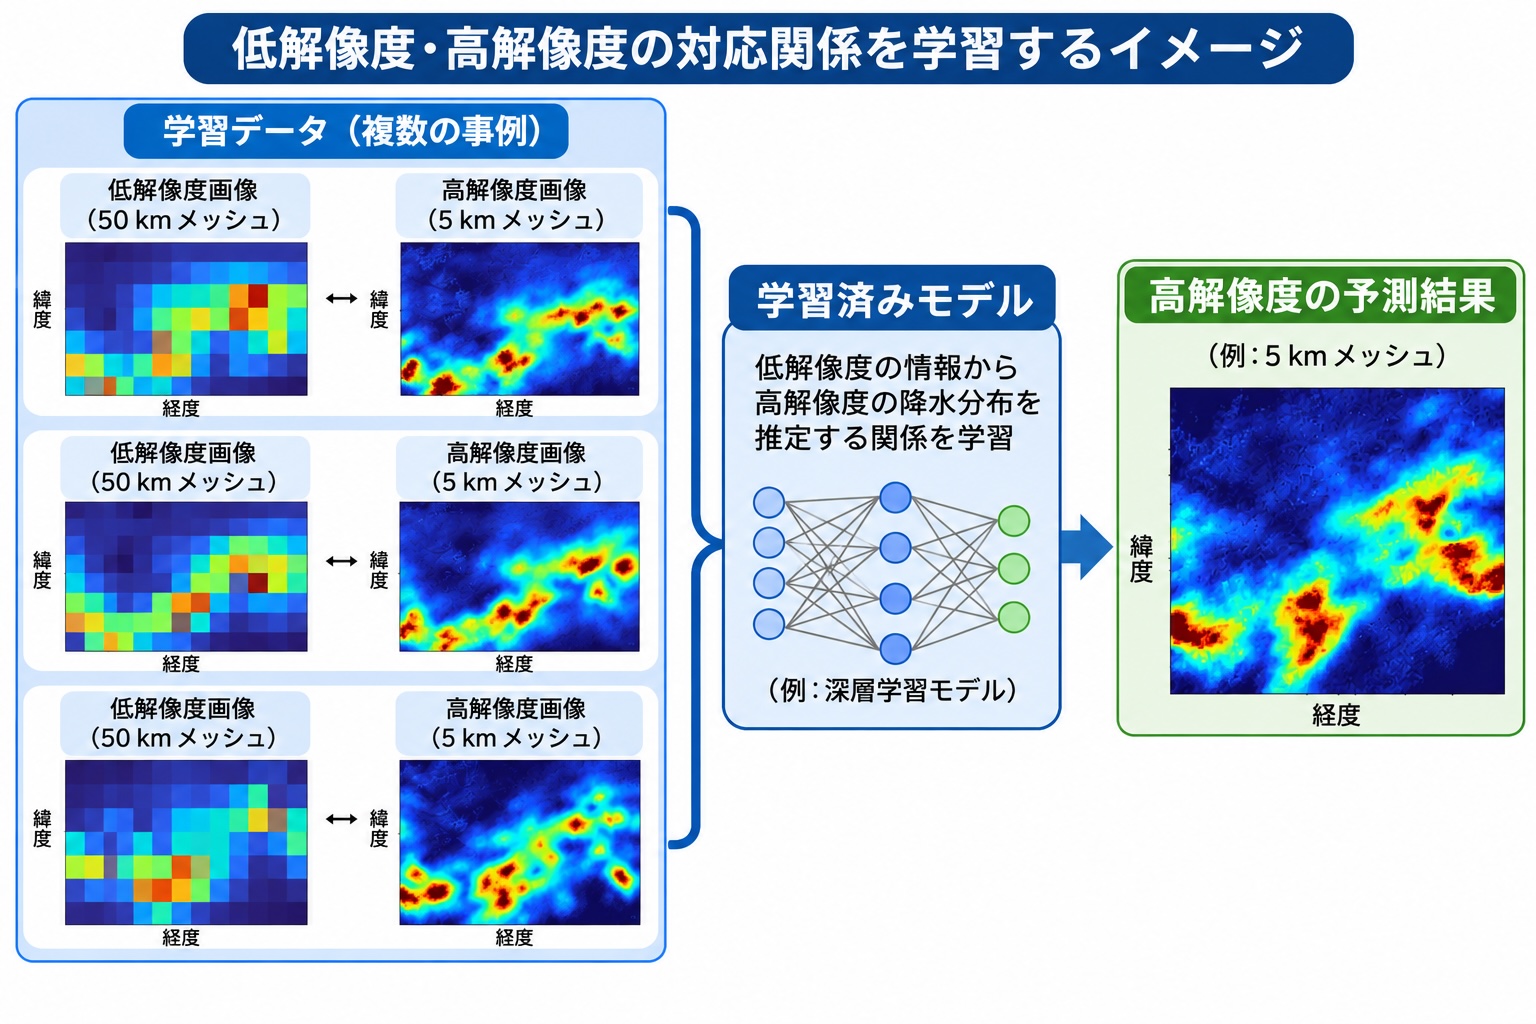
画像の超解像は、粗い画像と細かな画像の対応関係を学習し、粗い画像から細かな画像を推定する技術です。
図1:50 kmメッシュの低解像度の気象分布と、対応する5 kmメッシュの高解像度の気象分布を用いた学習の概念図です。実際の論文で扱う格子間隔とは異なる、仕組みを説明するための模式例です。
地点ごとの識別器が地形の影響を捉える仕組み
MLDSの特徴の一つは、地点ごとに識別器を構築することです。各識別器は、対象地点だけの値を見るのではなく、その周辺に広がる気象場の空間パターンを手掛かりにして、対象地点で現れやすい降水の特徴を学習します。
例えば、山地の風上側・風下側や平野部では、似たような広域の気象場であっても、降水の頻度や強度が異なることがあります。地点ごとに学習することで、こうした地域固有の違いが学習データに繰り返し現れていれば、その特徴を地点別の識別器に反映できます。このため、標高や傾斜などの地形データを説明変数として直接与えなくても、学習データに含まれる地形の影響を間接的に捉えられる可能性があります。
ポイント:
学習では、例えば次のような情報を手掛かりにします。
周辺格子に広がる降水域の位置や形状
周辺格子とのつながりや空間的な配置
時間とともに変化する降水システムのパターン
それぞれの地点で繰り返し現れる降水頻度や強度の特徴
従来型の例
説明変数を選ぶ
気温・湿度・風・気圧・地形など
→
関係を学習
統計・機械学習モデル
説明変数と目的変数の関係
→
MLDSの例
低解像度の気象場
周辺格子を含む空間パターン
→
地点ごとに学習
識別器
気象場のパターンと地点固有の特性の関係
→
推定
高解像度の分布
5 kmメッシュなどの細かな気象場
両者の比較
比較項目
従来型の統計的ダウンスケーリング
MLDSの地点別学習
基本的な考え方 説明変数と目的変数の統計的・機械学習的な関係を学習
周辺の気象場のパターンと地点ごとの気象特性との関係を学習
入力情報 目的に応じて気象要素や地形などを選択
周辺格子を含む低解像度の気象場。地形データは必須ではない
学習の単位 地点・地域の値や、説明変数と目的変数の組み合わせなど
地点ごとに識別器を構築し、周辺の空間パターンとの対応を学習
地形の影響 地形情報を説明変数として直接利用する方法がある
地点固有の学習を通じて、学習データに現れる地形の影響を間接的に反映できる可能性
主な利点 説明変数の役割を整理しやすく、目的に応じたモデルを設計できる
周辺の気象場のパターンを利用し、地点ごとの降水特性や空間分布を推定しやすい
主な課題 説明変数の選択や組み合わせ、モデル構造によって性能が左右される
学習データに依存し、未経験の気象条件や極端現象では推定性能が低下する可能性
MLDSの利点:
注意点:
なお、従来型にも複数の気象要素や空間情報を扱う手法、非線形な機械学習を使う手法があります。また、MLDSも広い意味では統計的ダウンスケーリングの一種です。ここでは、説明変数と目的変数の関係を中心に構築する方法と、地点ごとの識別器で気象場のパターンを認識する方法の代表的な違いを説明しています。