深層学習による気候外挿が難しい理由
近年、AIを気象予測や気候変動予測に活用する研究が急速に進展しています。CNNやU-Netによる高解像度化に加え、GANやDiffusion Modelなどの生成AIを用いて、粗い気象データから詳細な降水分布や極端現象を再現する研究も増えています。こうした技術は、気候変動に伴う地域的な気象リスクを評価するうえでも、大きな可能性を持っています。
一方で、AIを気候変動予測に利用する際の重要な課題の一つに、「気候の外挿問題」があります。多くの深層学習モデルは、過去の気象観測や再解析データを用いて、気象場と局地的な降水分布との関係を学習します。しかし、気候変動によって将来の気温や水蒸気量、大気の循環場などが変化すると、学習時には経験していない条件にモデルを適用することになります。このとき問題となるのが、学習時と適用時でデータの統計的な性質が変化する「分布シフト(Distribution Shift)」です。過去のデータで高い再現性能を示したモデルであっても、将来の気候条件で同じように機能するとは限りません[1, 3]。特に、GANやDiffusion Modelなどは、現実に近く自然な降水分布を生成できる一方で、その分布が将来の気候条件に対して科学的に正しいことを保証するものではありません。高解像度で自然な降水分布を生成できることと、将来の気候に対して正しい降水分布を予測できることは、別の能力です。ここでは、CNN・U-Net・GAN・Diffusion Modelなどの深層学習モデルを例に、気候外挿が難しい理由と、その背景にある分布シフトの仕組みを気象・降水の具体例を使って解説します[1, 3]。
1. 深層学習は何を学習しているのか
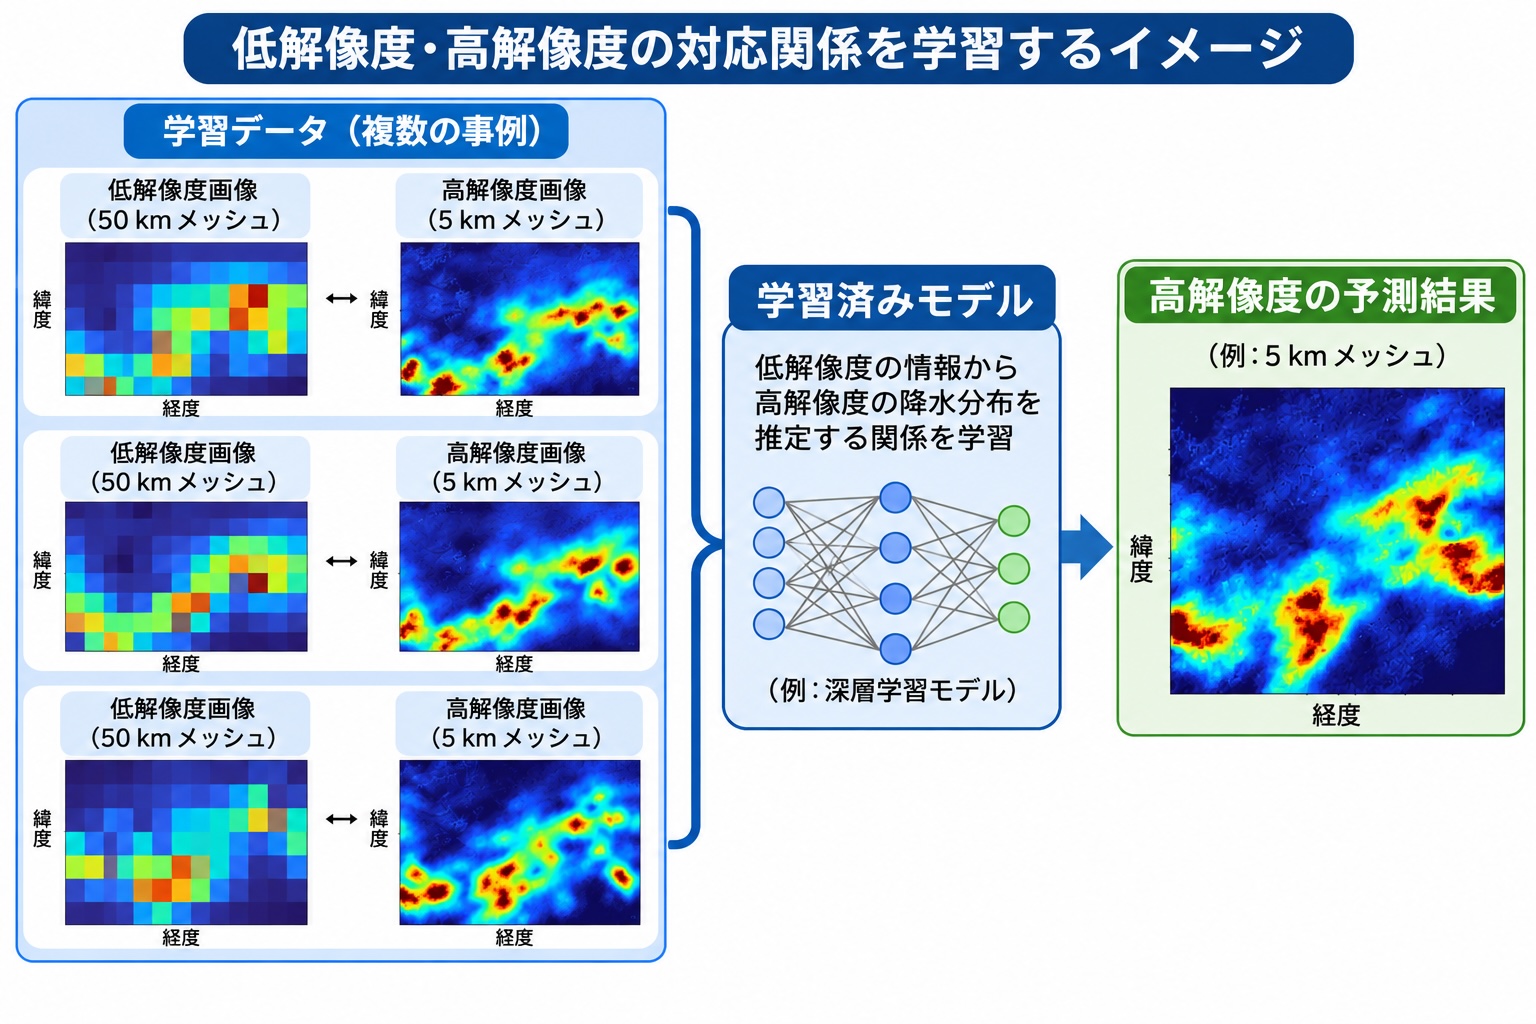
過去に学習した関係をそのまま適用できない可能性がある。
例えば、50 km程度の粗い気象データから、5 km程度の高解像度の降水分布を推定する場合を考えます。学習時には、過去の気象データを入力し、それに対応する高解像度の降水データを正解として、両者の関係を学習します。
このように、粗い解像度のデータから細かな解像度のデータを推定する技術は、超解像(Super-Resolution)と呼ばれます。気象分野でも、超解像技術を応用して高解像度の気象分布を生成する手法が多く開発されています。
ただし、気象分野のダウンスケーリングは、単に画像を高精細化することだけが目的ではありません。
気温・湿度・風・気圧などの大規模な気象場に加え、
地形などの影響を考慮しながら、局地的な気象特性を推定することが重要になります。
そのため、複数の気象要素と局地的な気象特性との関係を学習する方法も含まれます。
気温・湿度・風・気圧など
CNN・U-Netなど
局地的な降水域・強度
AIは、例えば次のような入力と出力の対応関係を学習します。
- 気温や湿度が高いとき、どのような降水分布になりやすいか。
- 風向や風速によって、山地の風上側・風下側の降水量がどう変化するか。
- 大規模な気圧配置と局地的な降水分布に、どのような関係があるか。
- どのような気象条件で局地的な強雨が発生しやすいか。
ただし、深層学習が学習するのは、基本的には過去のデータに現れた入力と出力の統計的な対応関係です。
気象現象の物理法則や因果関係を自動的に理解しているわけではありません[1]。
そのため、学習時とは異なる気象条件に適用した場合にも、
学習した対応関係が適切に成り立つとは限りません。
2. 分布シフトとは何か
分布シフト(Distribution Shift)とは、AIの学習時と実際の予測時で、入力データや予測対象の統計的な性質が変化することです[1]。
例えば、過去の気候では気温30℃前後のデータが中心だったのに、将来の気候では35℃以上の条件が頻繁に現れるようになったとします。AIは、学習時にほとんど経験していない高温条件に対して予測することになります。
模式図。実際の気温分布や変化幅を示すものではありません。
気候外挿では、気温の分布が変わるだけでなく、気象要素間の関係も変化する可能性があります。例えば、気温・水蒸気量・大気安定度・風の場などの組み合わせや、降水の発生条件が変わることがあります。
3. 気候外挿が難しい4つの理由
① 学習した範囲の外では、予測の根拠が弱くなる
深層学習は、学習データに含まれるパターンをもとに未知のデータを推定します。過去のデータに多く含まれる気温や降水強度では比較的安定した予測ができても、学習範囲を大きく超える条件では、推定の根拠が弱くなります。
例えば、過去のデータで気温30℃までの条件を十分に学習していても、将来に35℃や40℃という条件が頻繁に現れた場合、過去に学習した関係をそのまま延長して正しい結果になるとは限りません。
② 気象要素間の関係そのものが変化する
入力データの分布が変わるだけでなく、同じ入力条件に対する降水の発生頻度や強度が変わる可能性があります。機械学習では、次の2つを区別すると理解しやすくなります。
入力条件の分布が変化
過去には珍しかった高温・高湿度の組み合わせが、将来は一般的になるなど、入力データの分布が変化すること。
入力と出力の関係が変化
同じ気温・湿度・風の条件でも、将来は降水の発生頻度や強度が異なるようになること。
入力分布の変化であれば、学習データの拡充や適切な補正で対応できる場合があります。一方、入力と出力の関係そのものが変化すると、過去の学習結果をそのまま適用することは難しくなります。
③ 過去のデータに存在する相関関係を学習している
深層学習は複雑な非線形関係を学習できますが、それは気象現象の物理的な仕組みを理解していることと同じではありません。過去のデータでは有効だった相関関係が、将来の気候で崩れる可能性があります。
例えば、AIが降水を発生させる物理的な条件ではなく、過去のデータに多く含まれていた特定の気圧配置や季節的な特徴を手掛かりにしている場合です。このように、本質的な因果関係ではなく、予測に都合のよい表面的な特徴に依存することを、Shortcut Learning(ショートカット学習)と呼ぶことがあります。
④ 極端現象は学習データが少ない
過去30年間のデータを使って学習しても、一般的な降水は多数含まれる一方、数十年に一度の極端な豪雨は非常に少ない可能性があります。一般的な誤差を小さくする学習では、発生頻度の低い強雨の誤差が十分に反映されない場合もあります。
- 平均的な気温・降水量の再現
- 降水の発生頻度の再現
- 強雨の発生頻度の再現
- 極端な強雨の強度と空間分布の再現
これらは、それぞれ分けて評価する必要があります[3, 4]。
4. CNN・U-Net・GAN・Diffusion Modelの違い
各モデルはデータの表現方法や生成方法が異なります。ただし、モデルの生成能力が高くなっても、気候外挿の問題が自動的に解決するわけではありません[1, 3]。
| モデル | 主な特徴 | 気候外挿上の課題 |
|---|---|---|
| CNN | 畳み込みによって画像・気象場の局所的な特徴や空間パターンを抽出する。 | 未知の気象条件への対応は保証されない。一般的な誤差を小さくする学習では、極端値や細かな構造が平均化される場合がある。 |
| U-Net | エンコーダー・デコーダー構造とスキップ接続により、大規模な特徴と細かな空間情報を組み合わせる。 | 空間解像度を高める能力と、将来の気候条件への外挿能力は別問題。学習した統計的関係の変化に弱い。 |
| GAN | 生成器と識別器を競わせ、学習データに似たリアルな分布を生成する。 | 識別器が評価するのは学習データらしさであり、将来の気候で物理的に正しいかどうかではない。 |
| Diffusion Model | ノイズを段階的に除去してデータを生成し、多様なパターンや確率的なばらつきを表現する。 | 生成する分布は学習データから得た知識に依存する。未知の気候条件で新たに現れる現象を正しく生成できる保証はない。 |
GANやDiffusion Modelは、従来の決定論的なCNNよりも、降水の空間的な多様性や確率分布を表現するうえで有利な場合があります。しかし、これは主として「分布の表現能力」の改善であり、「未知の気候条件に対する予測能力」の改善とは区別する必要があります[3, 4]。
5. 見た目が自然でも、正しい気候予測とは限らない
GANやDiffusion Modelが、実際のレーダー降水分布と区別できないほど自然な降水パターンを生成したとします。それでも、次の点は別途検証しなければなりません。
- その降水強度は、将来の気候条件に対して適切か。
- 強雨の発生頻度は、将来の気候変化を反映しているか。
- 降水域の広がりや位置は、物理的に妥当か。
- 大規模な気象場との整合性は保たれているか。
- 将来の気候で発生する未知の降水パターンにも対応できるか。
特に、画像の精細さや自然さだけでモデルを評価すると、生成品質の高さを予測の信頼性の高さと誤解する可能性があります。
6. 気候外挿に対応するための方法
気候外挿を完全に解決する方法は確立されていませんが、次のような方向性が検討されています[1, 3]。
| 対応方法 | 目的・期待される効果 |
|---|---|
| 多様な気候条件で学習 | 高温・強雨など、学習データの範囲を広げる。 |
| 複数の気候モデルを利用 | 特定の気候モデルに依存した学習を避け、モデル間の違いに対する頑健性を調べる。 |
| 物理的制約を導入 | 水蒸気・エネルギーなどの物理的整合性を高める。 |
| 物理過程を考慮したモデル | 単なる相関だけでなく、気象現象の仕組みを反映する。 |
| ドメイン適応・転移学習 | 異なる気候条件やデータ特性にモデルを適応させる。 |
| アンサンブル化 | 予測のばらつきや不確実性を評価する。 |
① 将来の気候を想定した学習・検証
例えば、Pseudo Global Warming(PGW)実験では、現在の気象場に将来の気候変化による気温や水蒸気量などの変化を加え、将来に近い条件で気象現象を調べます。こうしたデータを利用すれば、温暖化した条件でAIがどの程度適切に予測できるかを検証できます。
ただし、PGWは既存の気象場に気候変化のシグナルを加える実験であり、将来の大気循環や降水構造の変化をすべて再現するものではありません。
② 物理的な整合性を確保する
AIに降水分布を生成させるだけでなく、水蒸気の輸送、大気の安定度、気温と湿度の熱力学的関係、地形による強制上昇、大規模場と局地的な降水の関係などの物理的知識を学習に取り入れる方法です。これによって、過去のデータに存在する表面的な相関だけに依存するリスクを減らせる可能性があります。
ただし、物理的制約を導入すれば、未知の気候条件でも正確になるというわけではありません。
③ 外挿性能を評価する
通常のランダムな学習・検証データ分割では、学習データと検証データの気候特性が似ているため、将来気候への外挿能力を十分に評価できない場合があります。時間的・気候的に独立した検証が重要です。
- 過去の気候で学習:例えば1980~2000年のデータを使用する。
- 異なる期間で検証:2001~2010年など、学習に使っていない期間で評価する。
- 温暖化した気候で検証:高温・高湿度など、過去の学習範囲を超える条件を含むデータを使用する。
- 別の気候モデルで検証:学習に使用していないGCMのデータにも適用する。
- 極端現象を重点評価:平均誤差だけでなく、強雨の頻度・強度・空間分布などを比較する。
このような検証によって、過去の気候を再現できるモデルなのか、異なる気候条件にもある程度対応できるモデルなのかを区別しやすくなります[1, 2, 3]。
7. 機械学習ダウンスケーリングとの関係
ここまでの問題は、CNNやU-Netなどによる超解像だけでなく、多くの機械学習による統計的ダウンスケーリングにも共通します[2, 3]。
例えば、過去の気象データから、大規模な気象場、地形、気温・湿度、風向・風速と局地的な降水分布との関係を学習したとします。過去の気候に対して高い再現性を示しても、将来の気候で大気の状態や降水の発生条件が変化すれば、学習した関係が適切でなくなる可能性があります[1, 2]。
細かく再現する能力
過去に存在した気象パターンを高解像度化する。地形や局地的な降水分布などを細かく表現する。
未知の条件に対応する能力
気候変動によって変化した気象要素間の関係を適切に推定する。過去に十分経験していない条件にも対応する。
例えば、5 km解像度で非常に精細な降水分布を生成できたとしても、その降水量や発生頻度が将来の気候に対して正しいとは限りません。高解像度化技術の評価と、気候変動に対する外挿性能の評価は分けて行う必要があります。
8. まとめ
深層学習による気候外挿が難しい理由は、単に未知のデータに弱いからではありません。本質的には、気候変動によって、AIが過去のデータから学習した統計的な関係そのものが変化する可能性があるためです。
- CNN・U-Netは、過去の空間パターンを高解像度化できるが、未知の気候条件への対応は保証されない。
- GAN・Diffusion Modelは、複雑な確率分布や多様な降水パターンを生成できるが、将来の気候に適合した分布を生成できるとは限らない。
- 物理的な仕組みを十分に反映していない場合、過去の相関関係が崩れることで予測性能が低下する可能性がある。
- 極端現象は学習データが少なく、将来の発生頻度や強度の変化を適切に推定することが難しい。
- 将来気候や異なる気候モデルを使った外挿検証が不可欠である。
これは、将来の降水予測や洪水リスク評価などにAIダウンスケーリングを利用する場合にも重要な課題です。
参考文献
- Beucler, T., Gentine, P., Yuval, J., et al. (2024). “Climate-invariant machine learning.” Science Advances, 10(6), eadj7250. https://doi.org/10.1126/sciadv.adj7250
- Maraun, D. (2016). “Bias Correcting Climate Change Simulations – a Critical Review.” Current Climate Change Reports, 2, 211–220. https://doi.org/10.1007/s40641-016-0050-x
- Najafi, H., Lagerwall, G. L., Obeysekera, J., & Liu, J. (2026). “Machine Learning in Climate Downscaling: A Critical Review of Methodologies, Physical Consistency, and Operational Applications.” Water, 18(2), 271. https://doi.org/10.3390/w18020271
- Daust, K., Monahan, A., & Mahony, C. (2026). “Generative Adversarial Networks for Deep Learning Downscaling of Temperature, Humidity, and Precipitation.” Artificial Intelligence for the Earth Systems, 5(3). https://doi.org/10.1175/AIES-D-25-0095.1
本文中の [番号] は、上記参考文献に対応しています。